카메라 워크: 샷 사이즈에 관하여 - FS, LS, ELS
카메라 워크 샷 사이즈 - FS, LS, ELS에 대해 알아봅니다.
풀샷, 롱샷, 익스트림 롱샷 — 공간을 보는 거리
샷 사이즈 두 번째 글입니다. 1편에서는 익스트림 클로즈업(ECU)부터 미디엄 샷(MS)까지, 카메라가 인물에 붙어 있는 구간을 다뤘습니다.
거기까지가 감정을 보는 거리였다면, 이제부터는 상황, 공간을 보는 거리입니다. 카메라가 물러날수록 얼굴은 작아지고 그 사람이 어디에 서 있는지가 보이기 시작합니다. 감정이 희미해진 자리를 공간이 채우는 셈입니다.
이번 글의 샷들은 중심이 감정에서 정보(상황, 공간)로 옮겨간 샷이라고 정리할 수 있습니다.
셋의 차이는 여백에서 갈립니다
먼저 구분 기준부터 잡고 가겠습니다. 이 세 가지를 헷갈리는 경우가 많은데, 몸이 잘렸느냐가 아니라 여백이 얼마나 남았느냐로 나누면 간단합니다.
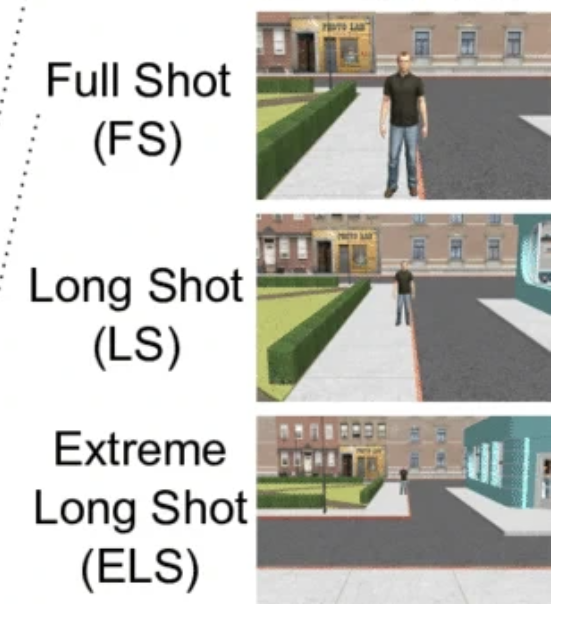
| 약어 | 이름 | 여백 | 화면의 주인공 |
|---|---|---|---|
| FS | 풀 샷 (전신 샷) | 전신이 프레임을 거의 채움 | 인물 |
| LS | 롱 샷 (와이드 샷) | 위아래 좌우로 공간이 넉넉함 | 인물과 공간 |
| ELS | 익스트림 롱 샷 | 인물이 점처럼 작거나 아예 없음 | 공간 |
셋 다 전신이 담긴다는 점은 같습니다. 달라지는 건 그 전신 주위에 무엇이 얼마나 들어오느냐입니다.
풀 샷 (FS)
머리끝부터 발끝까지 전신을 온전히 담습니다. 전신 샷이라고도 부릅니다.
이 거리에서는 얼굴의 미세한 떨림이 사라집니다. 대신 자세, 걸음걸이, 손짓 같은 신체 언어 전체가 읽힙니다. 1편의 클로즈업이 이 사람이 무엇을 느끼는가를 보여준다면, 풀 샷은 이 사람이 무엇을 하고 있는가를 보여줍니다.
그래서 액션과 춤, 무술 장면의 기본 사이즈가 됩니다. 동작이 어디서 시작해 어디로 가는지 관객이 눈으로 따라갈 수 있어야 하는데, 그러려면 몸이 잘리면 안 됩니다.
캐릭터의 첫 등장에도 자주 쓰입니다. 의상, 체형, 실루엣이 한 번에 들어오기 때문에 대사 한 줄 없이 이 사람이 어떤 사람인지 선언할 수 있습니다.
몸이 대사를 대신할 때
영화 「라라랜드」(2016), 출처: Movieclips 채널
라라랜드의 언덕 위 춤 장면이 좋은 예입니다. 카메라가 두 사람을 따라다니면서도 컷을 좀처럼 나누지 않습니다.
몸 전체를 계속 보여준다는 건 이 장면에서 볼 것이 표정이 아니라는 뜻입니다. 두 사람의 호흡이 맞아가는 과정, 발이 같은 박자로 움직이기 시작하는 순간이 이 장면의 내용이고, 그건 얼굴을 확대해서는 보이지 않습니다.
동작을 사실로 전달할 때
영화 「매트릭스」(1999), 출처: Movieclips 채널
매트릭스에서 네오와 모피어스가 도장에서 대련하는 장면은 전체적으로 풀 샷을 유지하면서 사이사이 다른 사이즈를 섞습니다.
무술 장면에서 풀 샷을 유지한다는 건 배우와 스턴트에 대한 자신감의 표현이기도 합니다. 풀 샷 액션은 동작을 사실로 전달합니다. 관객이 몸의 궤적을 처음부터 끝까지 볼 수 있습니다. 요즘 액션물이 클로즈업과 빠른 컷으로 동작을 느낌으로 전달하는 것과는 비교되는 점입니다.
롱 샷 (LS)
전신이 담기되 주변 공간이 넉넉하게 함께 들어옵니다. 와이드 샷이라고도 부릅니다.
인물이 화면의 일부가 되면서 배경이 말을 하기 시작합니다. 그가 처한 상황과 처지가 공간을 통해 설명됩니다.
장면의 시작을 여는 역할도 합니다. 이걸 이스타블리싱 샷(establishing shot)이라고 부르는데, 여기가 어디이고 누가 있는지를 먼저 알려주는 샷입니다.
여백을 이용한 고립
영화 「마션」(2015), 출처: 20th Century Studios 채널
마션에는 얼굴도 표정도 보이지 않는 뒷모습으로 시작하는 장면이 있습니다. 뒷모습이라는 것만으로 이미 혼자라는 정보가 전달됩니다.
여기에 프레임의 여백이 더해집니다. 인물 주위에 아무것도 없는 공간이 넓게 남아 있으면 그 빈자리가 거리감과 막막함으로 읽힙니다. 고독이나 무력감을 표현할 때 인물을 작게 잡는 이유입니다.
익스트림 롱 샷 (ELS)
인물이 아주 작게 보이거나 아예 보이지 않을 정도로 광활한 공간을 담습니다. 풍경 자체가 주인공이 되는 구간입니다.
인물은 점이 됩니다. 표정도 동작도 읽히지 않고, 대신 그가 놓인 세계의 규모가 압도적으로 전달됩니다. 사막, 바다, 설원, 우주처럼 인간이 통제할 수 없는 공간과 만났을 때 효과가 가장 큽니다.
오프닝과 엔딩에 자주 배치되는 것도 이 때문입니다. 크게 열고 크게 닫으면 이야기 전체가 하나의 세계처럼 느껴집니다. 여정의 규모를 한 컷으로 압축할 수도 있습니다. 이 사람이 아주 먼 길을 왔다는 것을 설명하는 가장 빠른 방법은 대사가 아니라 지평선입니다.
속도가 크기 앞에서 무력해질 때
영화 「매드맥스: 분노의 도로」(2015), 출처: Movie Camera Shots 채널
매드맥스는 영화 대부분이 추격으로 이루어져 있습니다. 그런데 중간중간 카메라가 아주 멀리 물러나 사막 전체를 담는 순간들이 있습니다.
가까이서 볼 때 그 차량들은 굉음을 내며 맹렬하게 달립니다. 그런데 화면이 넓어지는 순간 같은 차들이 지평선 아래 작은 점들로 바뀝니다. 엔진 소리는 여전히 큰데 화면 속 존재는 알아보기도 힘들 만큼 작습니다. 소리의 크기와 화면 속 크기가 어긋나면서, 이 질주가 얼마나 광활한 공간 속에서 벌어지고 있는지가 드러납니다.
이게 익스트림 롱 샷이 하는 일입니다. 클로즈업에서는 속도가 곧 힘으로 읽히지만, 충분히 멀리서 보면 그 속도가 아무것도 바꾸지 못한다는 사실이 함께 보입니다.
세계관을 납득시킬 때
같은 샷이 세계의 규모를 설명하는 역할도 합니다. 「매드맥스: 분노의 도로」에는 배경 설명이 거의 없습니다. 이 세계가 왜 이렇게 됐는지 인물들이 길게 설명하지 않습니다.
대신 아무것도 없는 사막이 화면 끝까지 이어지는 장면을 보여줍니다. 물도 없고 사람도 없고 방향을 알려줄 표지도 없는 공간이요. 관객은 설명을 듣는 대신 그 상태를 눈으로 확인합니다. 이 세계에서 물이나 연료가 왜 그렇게 중요한지도 자연스럽게 납득됩니다.
세계관이 방대한 에픽 장르에서 이 샷이 자주 쓰이는 이유입니다. 「듄」이나 「반지의 제왕」 시리즈도 같은 방식으로 자신들의 세계를 설득합니다.
AI로 만들어봤습니다
Klipse에서 두 가지를 만들었습니다. 각각 샷 사이즈가 단계적으로 넓어지는 구성입니다.
아래는 작업 환경입니다.
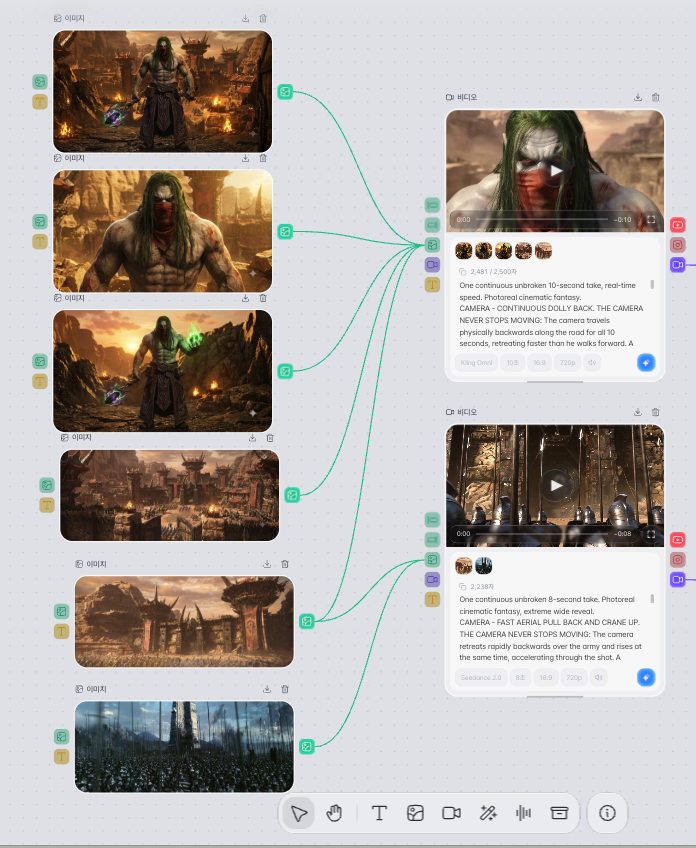
CU → MCU → MS → MFS → FS → LS
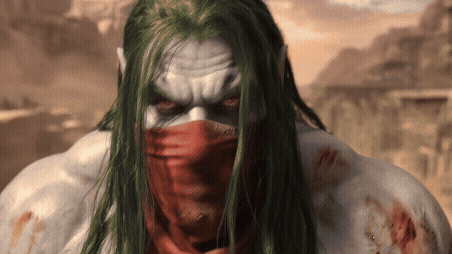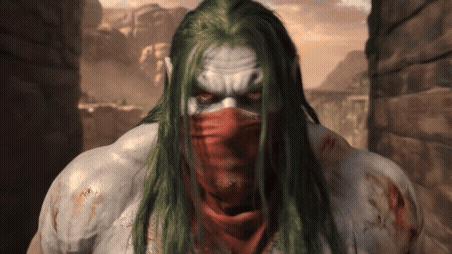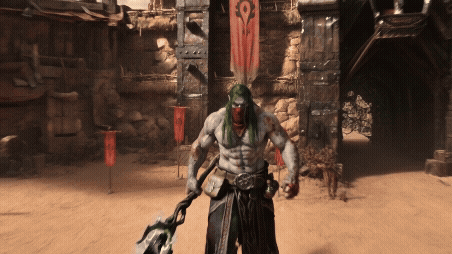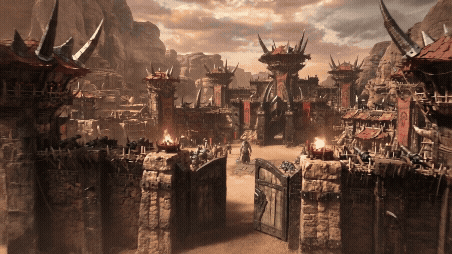
프롬프트 - 대괄호 안을 영어로 채워서 쓰시길 추천드립니다.
CAMERA — [카메라 이동 방식: 후퇴 돌리]. THE CAMERA NEVER STOPS MOVING: The camera travels physically backwards for all [N] seconds, retreating faster than [피사체]가 다가오는 속도. A physical [dolly] move, not a zoom, not a cut. Framing over time: 0-2s: [CU] — [얼굴의 무엇이 프레임을 채우는가] 2-4s: [MCU] — [상반신 어디까지 + 프레임 가장자리에 무엇이 들어오는가] 4-6s: [MS] — [허리 위 전체 + 배경의 무엇이 보이기 시작하는가] 6-8s: [FS] — [인물 전신 + 그 뒤에 무엇이 솟아오르는가] 8-10s: [LS] — [인물이 얼마나 작아지는가 + 무엇이 프레임을 지배하는가] [단, 전신 실루엣은 여전히 읽힐 것] [피사체]는 중앙에 고정, 배경은 점점 커지며 프레임을 채운다. Strong parallax. Foreground [전경 요소] sweeping past the frame edges. LENS: [초점거리]mm fixed, never zooming. [얕은 심도로 시작 → 물러날수록 깊어져 배경이 읽히는 지점까지]
MS → MFS → FS → LS → ELS
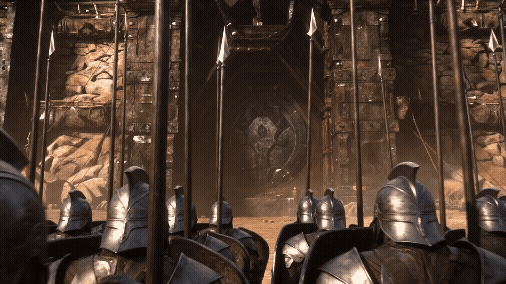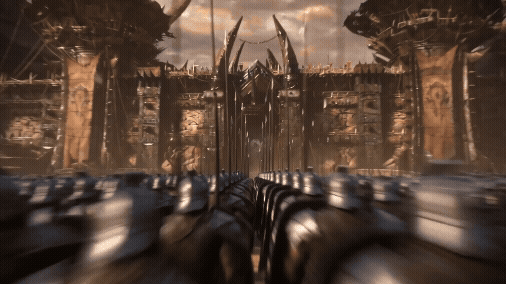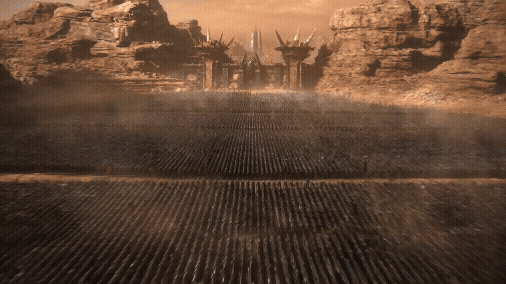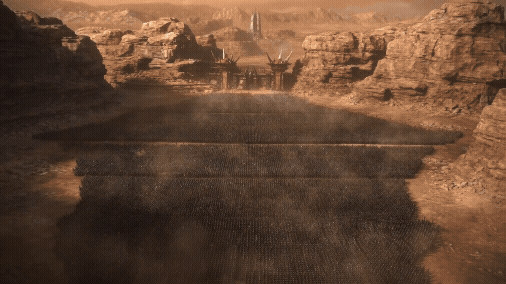
CAMERA — [이동 방식: 후퇴 + 상승, 가속]. THE CAMERA NEVER STOPS MOVING: The camera retreats rapidly backwards over [집단]과 동시에 상승, accelerating through the shot. A physical [aerial / crane] move, not a zoom, not a cut. Framing over time: 0-2s: [MS] — [배경 구조물이 프레임을 채움 + 하단 가장자리의 무엇] 2-4s: [MFS] — [카메라 상승 시작 + 구조물이 작아지고 무엇이 하단을 채우는가] 4-6s: [FS] — [집단 뒤 높은 공중 + 구조물이 얼마나 멀어졌는가] 6-8s: [LS→ELS] — [집단이 어디부터 어디까지 뻗는가 + 개체 식별 불가] Strong parallax, heavy motion blur from the speed of the move. LENS: [초점거리]mm wide, deep depth of field, natural motion blur at 24fps. [원경 처리: 먼지·안개로 흐려 끝을 감출 것]
프롬프트는 되도록 영어로 쓰시기를 권장합니다. 샷 사이즈 용어는 영어권에서 정착된 것이라 한글로 풀어 쓰면 모델이 다르게 해석하는 경우가 많습니다.
<!-- [작성 예정] 두 영상을 만들면서 관찰한 것 두세 가지. 예를 들어 사이즈 전환을 시간 구간으로 지정했는지, 인물의 일관성이 유지되는 한계 사이즈가 어디였는지 등 -->정리하며
1편의 샷들이 관객을 인물 안으로 끌어당겼다면, 2편의 샷들은 관객을 인물 밖으로 밀어냅니다.
좋은 장면은 대체로 이 둘을 오갑니다. 멀리서 상황을 보여주고, 가까이 다가가 감정을 보여주고, 다시 물러나 결과를 보여주는 식입니다. 이 글에서는 설명을 위해 사이즈별로 잘라서 봤지만, 실제 영화에서 샷 사이즈의 전환은 훨씬 자주 일어납니다.
용어를 정확히 맞추는 것보다 중요한 건 판단입니다. 이 장면에서 관객이 인물을 봐야 하는가, 상황을 봐야 하는가. 그것만 정하면 사이즈는 자연스럽게 정해집니다.